対象となる企業
自社モデルを、事業の力に変えたい開発チームへ。
モデルを導入するだけではなく、自社のデータと評価基準で継続的に育てたい企業と一緒に研究開発します。
自社AIサービスを開発している
汎用モデルとの差をつくり、製品固有の品質を高めたいチーム。
専門データを学習へ活かしたい
保有データを整理し、学習や評価に使える資産へ変えたいチーム。
改善効果を比較して判断したい
RAG、SFT、継続事前学習のどこへ投資すべきか確かめたいチーム。
研究開発の範囲
課題と評価方法から、一緒に設計します。
目的と評価方法を共有し、学習データの設計からモデルの学習・改善までを一緒に研究開発します。
01
学習データ設計
権利と利用条件を確認しながら、文書・コード・画像の構造化、コーパス整備、重複除去、品質確認を行います。
02
モデル学習
継続事前学習やファインチューニングを小規模な比較実験から検証し、対象モデルと計算資源に合う構成を選びます。
03
評価・改善
評価データ、失敗分析、再評価をつなぎます。ベースモデルやRAGのみの構成とも比較し、改善幅と費用を確認します。
進め方
小さく確かめ、再現できる形にします。
- 01
目的を定義する
対象業務、現在のモデル、期待する品質、判断に使う評価指標を整理します。
- 02
基準性能を測る
既存モデルとRAGなど、学習前に実現できる品質・速度・費用を測定します。
- 03
学習と改善を比較する
必要な技術だけを適用し、同じ評価条件で改善幅と失敗例を確認します。
- 04
社内で育てられる資産にする
コード、評価データ、設定、導入手順をまとめ、再検証できる状態で届けます。
提供するもの
結果だけでなく、改善を続けるための資産を。
- 学習・評価・推論のソースコード
- 評価データと比較結果
- 学習設定と実行環境の記録
- 導入・カスタマイズガイド
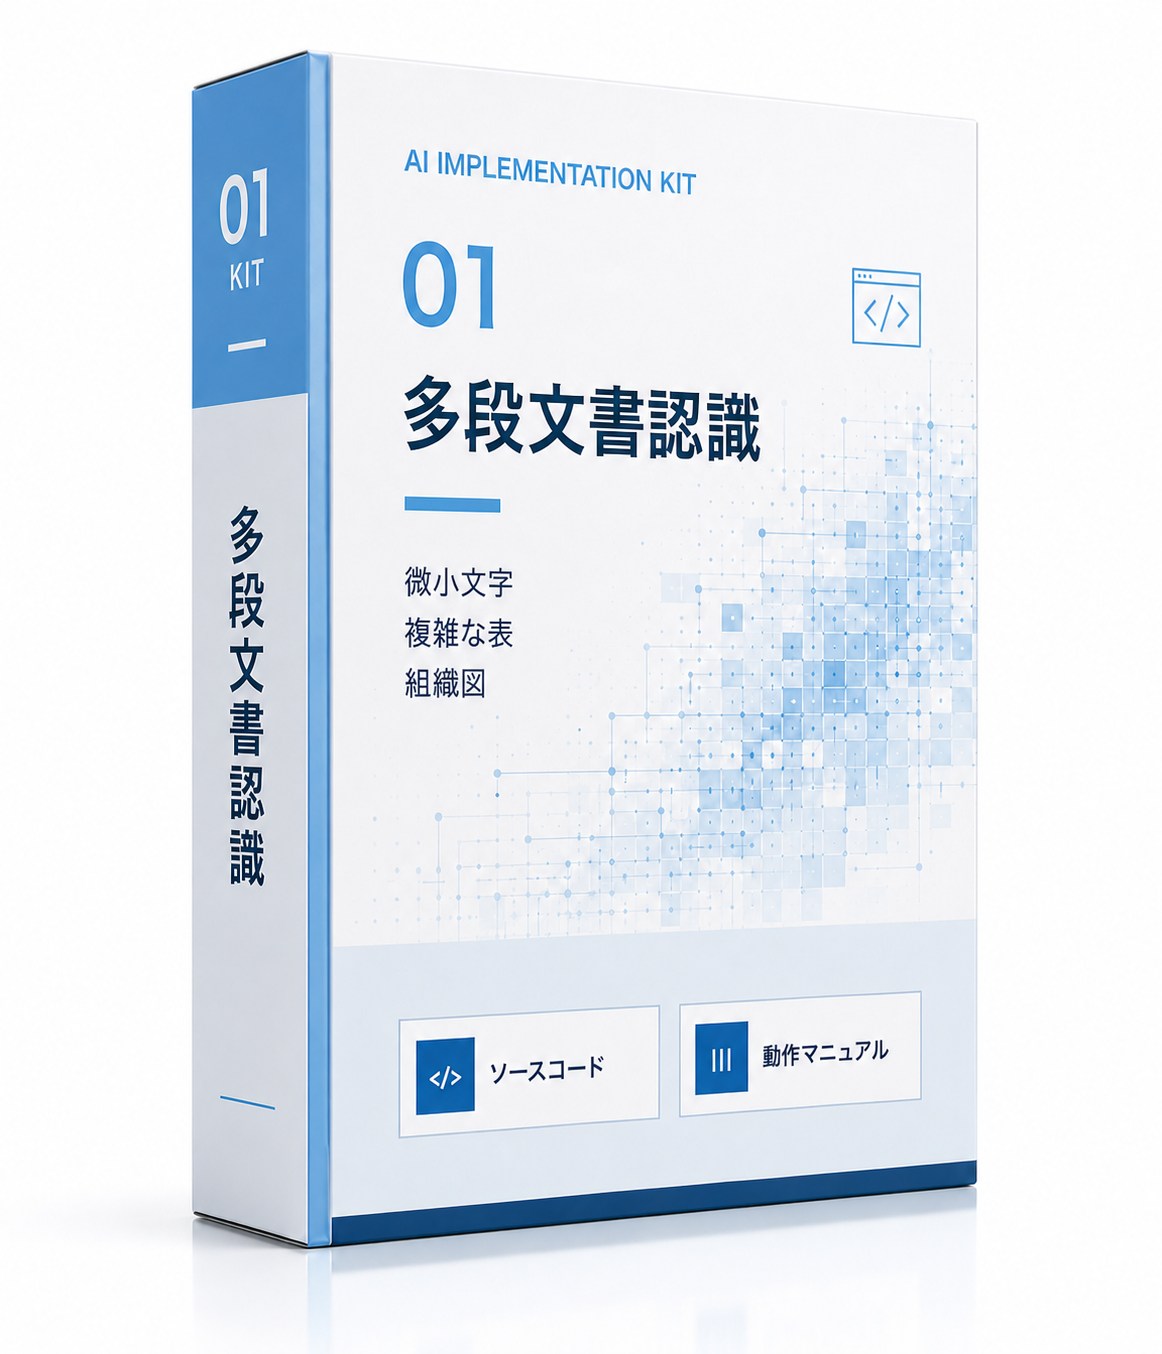
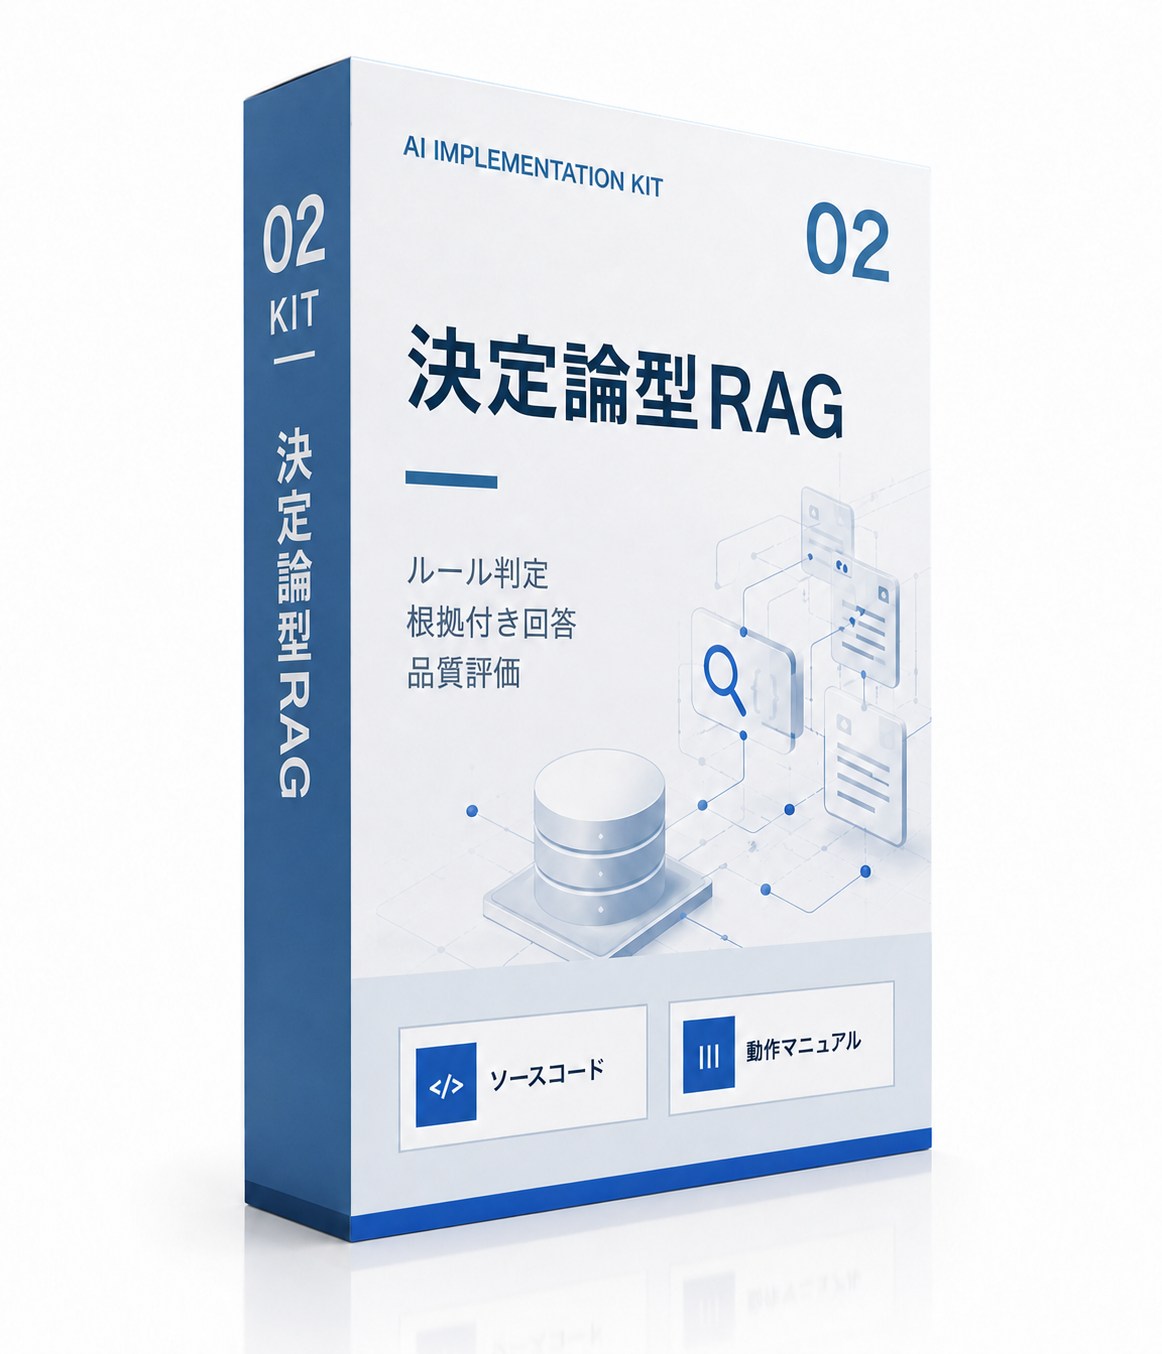
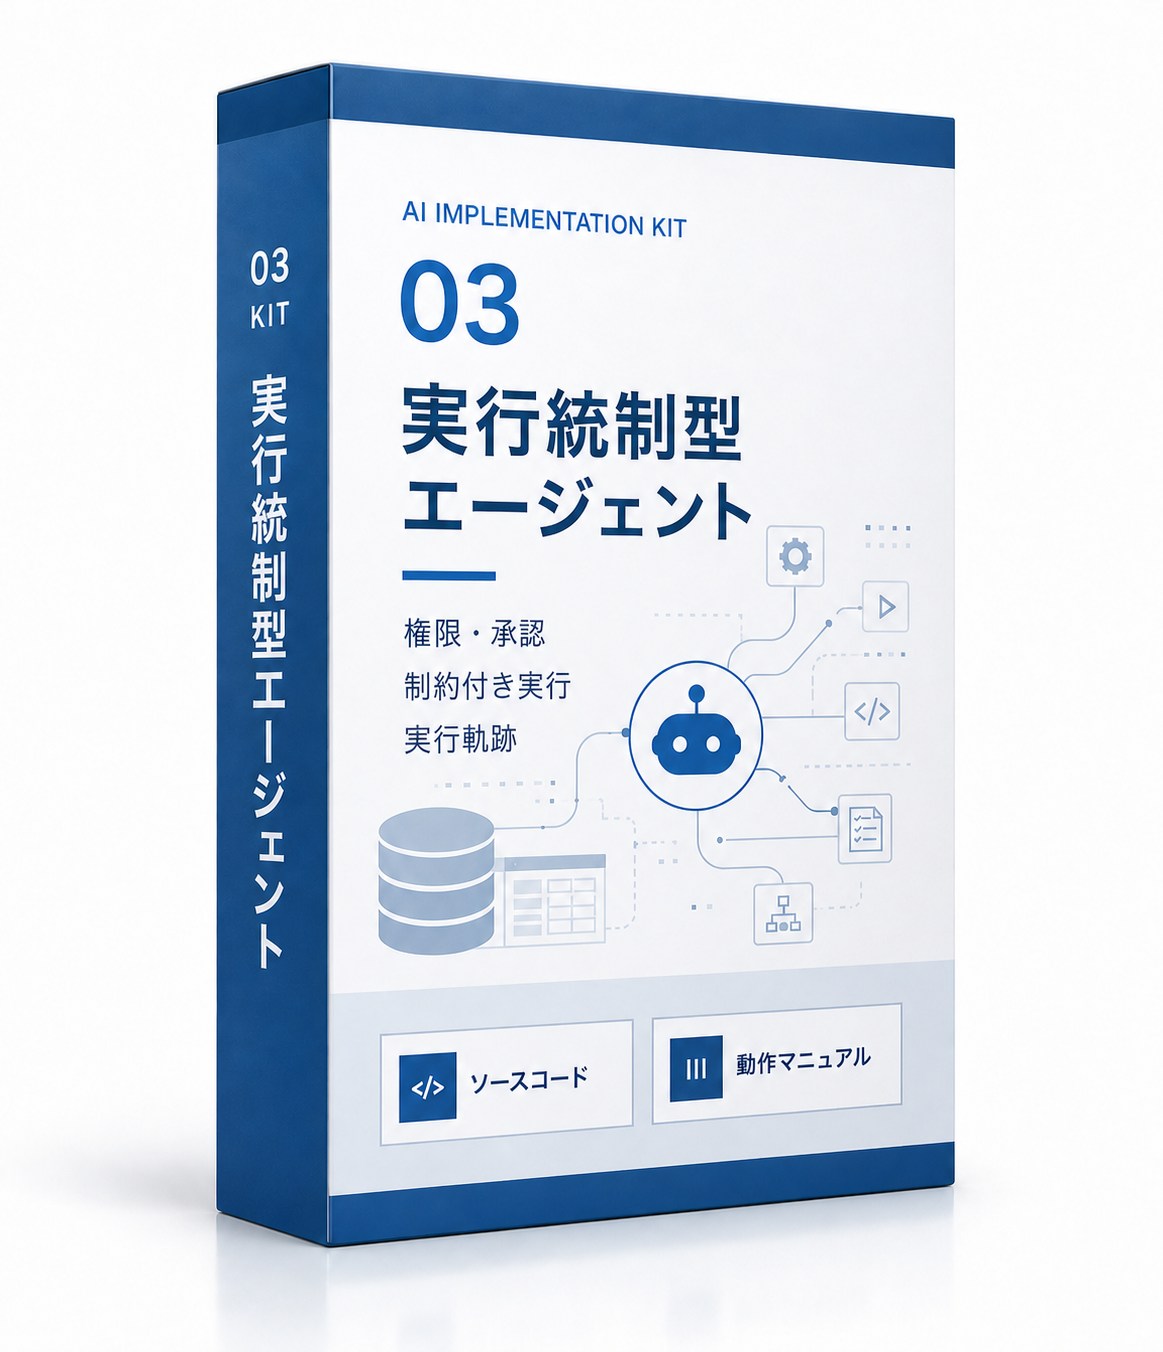
先端技術実装キット
先端技術知見を自社資産に組み込み差別化
 |
 |
 |
モデル学習技術の検証支援
世界トップクラスの大規模モデル学習を独自の手動分散手法で検証支援
データセット作成
クリーンなデータを作成